2. června 2026
Benchmark Finance Agent: hodnocení a zlepšování AI pro finance
Představujeme Finance Agent Benchmark, který je navržen k vyhodnocení, jak efektivně AI finance agenti obstojí v reálných scénářích.
Neoficiální české shrnutí a překlad článku Microsoftu. Web není oficiálním kanálem Microsoftu. Originál: Finance Agent Benchmark: evaluating and improving AI for Finance (Microsoft Copilot Blog).
S tím, jak roste složitost byznysu, dostávají finanční týmy stále víc požadavků: obsloužit více stakeholderů, podpořit více rozhodnutí a fungovat v dosud nevídaném tempu – často bez navýšení kapacit. Jakmile tyto nároky přerostou možnosti tradičních nástrojů a procesů, otevírá se prostor pro AI, která může zásadně změnit, jak finance škálují svůj dopad. Finance Agent in Microsoft 365 Copilot je na tuto změnu navržený: pomáhá finančním týmům rozšířit kapacitu, zrychlit práci a zvýšit přesnost a zároveň dodávat insighty, které podporují rozhodování.
🎬 Pusťte si video: Finance Agent
Microsoft nyní představuje Finance Agent Benchmark – benchmarkovací framework, který se skládá z evaluačního datasetu a evaluačního harnessu. Je navržený tak, aby prověřil, jak dobře si AI finance agenti vedou v reálných finančních scénářích. Kombinuje metriky vytvořené přímo pro tento účel, scénáře specifické pro finance a metodiku skórování tak, aby výsledky dávaly smysl v praxi.
První vydání Finance Agent Benchmark zahrnuje úlohy jako příprava finančních business briefů nebo analýza finanční výkonnosti. Vychází jak z důvěryhodných zdrojů dat (včetně veřejných SEC filings a tržních dat přes MSN Money), tak ze syntetických interních dat pro Accounts Payable a Accounts Receivable.
Tento technický deep dive popisuje, jak je Finance Agent navržený, jak je benchmark strukturovaný a skórovaný, a také porovnává výsledky Finance Agent v benchmarku s OpenAI Responses API s GPT 5.5 a Anthropic Claude CLI s Claude Opus 4.7.
Finance Agent v architektuře Microsoft 365 Copilot
Finance Agent je postavený na modulární agentní architektuře, která má organizacím pomoct vytěžit maximum z finančních dat a zároveň využít AI ekosystém Microsoftu – včetně enterprise bezpečnosti a compliance kontrol, jako je přístup řízený identitou (Microsoft Entra ID), izolace dat na úrovni tenantu, šifrování při přenosu i v klidu a governance možnosti Microsoft Purview (např. sensitivity labels, data loss prevention a audit logging). Základem návrhu je jednotný agentní backend, který orchestruje finančně specifické schopnosti, jako je generování finance business brief, průzkum finanční výkonnosti konkrétní entity nebo zjišťování finančních závazků entity ve vztahu k uživatelské společnosti.
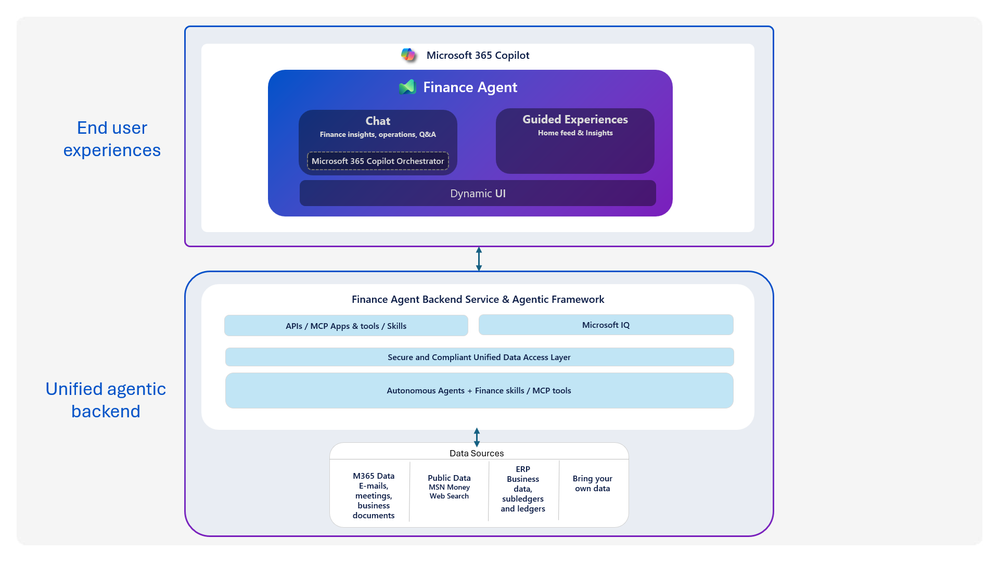
Architektura Finance Agent zahrnuje dynamické, kontextově řízené UI, které se generuje za běhu. Místo statických obrazovek systém skládá prvky UI v reálném čase podle role uživatele, fáze workflow a aktuálního kontextu úkolu. Platforma tak průběžně vytváří prostředí, které se přizpůsobuje tomu, kde se uživatel ve workflow nachází a jakou akci se snaží dokončit. Díky tomu vznikají vysoce personalizované, scénářově orientované interakce (např. dohledání historie fakturace), kdy se UI prvky, nástroje a insighty skládají v reálném čase tak, aby uživatele provedly finančními procesy, jako je analýza, reconciliation nebo reporting.
Jednotný agentní backend integruje API, MCP aplikace, nástroje a skills s vrstvou pro přístup k datům navrženou pro enterprise scénáře. To umožňuje plynulé napojení na pracovní kontext v Microsoft 365, ERP systémech i externích finančních zdrojích. Tento agentní framework pak dokáže inteligentně řídit jak získávání dat, tak i uživatelskou zkušenost – a to v těsném propojení.
Kombinace AI backendu a dynamické UI vrstvy přináší do Microsoft 365 Copilot hluboce integrované, na workflow zaměřené prostředí, ve kterém mohou finance týmy získávat insighty, dělat analýzy a realizovat procesy přímo v rámci svého běžného způsobu práce.
Metodika vyhodnocení Finance Agent v Microsoft 365 Copilot
Microsoft vyhodnotil Finance Agent pomocí účelově vytvořeného benchmarku, který co nejvěrněji kopíruje reálné finanční workflow – včetně načítání dat z ERP a finančních analýz napříč více entitami. Benchmark stojí na transparentní metodice, takže výsledky lze nezávisle ověřit a reprodukovat. Aby test odpovídal každodenním úkolům a problémům finančních týmů, vznikal ve spolupráci s finance profesionály z více odvětví. Benchmark je navržený tak, aby šel spouštět opakovaně – díky tomu lze konzistentně měřit zlepšení a udržet výsledky dlouhodobě srovnatelné.
Microsoft sestavil dataset pokrývající tři oblasti finančních úloh: (1) přípravu finance business briefs, (2) zjišťování finančních závazků entit ve vztahu k firmě uživatele a (3) analýzu finanční výkonnosti entit. Dataset obsahuje zhruba 300 otázek napříč těmito oblastmi a zahrnuje více odvětví, typů společností i finančních rolí:
- Finance business briefs preparation: Strukturovaný „intelligence report“ o společnosti – kombinuje finanční výkonnost, strategický kontext a historii z ERP – v podobě, jakou by finanční analytik připravil před vyjednáváním nebo rozhodnutím o úvěru.
- Entity financial obligations with the user company research: Odpovědi na dotazy z oblasti accounts payable a accounts receivable nad daty z Dynamics 365 Finance, včetně zůstatků dodavatelů, stáří faktur a platebních závazků.
- Entity financial performance research: Odpovědi na faktické dotazy vázané na konkrétní období, které popisují finanční kondici firmy (např. tržby, marže, zadlužení a poslední reportované výsledky) opřené o veřejná podání a tržní data.
Aktuální verze Finance Agent je zaměřená na rychlé odpovědi v konverzačním prostředí, proto jsou pro odpovědi nastavené limity latence: 60 sekund pro otázky k finančním údajům entit a 300 sekund pro generování business brief.
Finance Agent Microsoft porovnal se dvěma alternativními systémy, aby ověřil, jak si vede z pohledu uživatelské zkušenosti i výsledků oproti agentním runtime prostředím pro obecné použití, která nejsou cíleně navržená pro finanční scénáře: OpenAI’s Responses API a Anthropic’s Claude Code CLI. Oba systémy měly stejný přístup k nástrojům jako Finance Agent, včetně Dynamics 365 Finance MCP Server a webového vyhledávání, a běžely se společnými systémovými instrukcemi, které měly simulovat zkušenost finance profesionála při práci s AI agentem. Microsoft použil v době vyhodnocení (květen 2026) modely optimalizované na latenci od jednotlivých poskytovatelů: Anthropic’s Claude Haiku 4.5 a Claude Opus 4.7 a OpenAI’s GPT 5.5, všechny nastavené na low reasoning effort. Modely optimalizované na latenci byly zvolené tak, aby odpovídaly stejným limitům, které platí pro Finance Agent: 60 sekund pro otázky k finančním údajům entit a 300 sekund pro generování business brief. V samostatných experimentech s výchozím nastavením reasoning tyto systémy často časové limity překračovaly, což vedlo k vysokému počtu timeoutů a horšímu výkonu. Pokud se latence neomezuje, modely s high reasoning effort se výrazně zlepší, ale za cenu delší odezvy. Detailní výsledky pro high reasoning effort u všech tří srovnávaných řešení Microsoft doplní v další verzi Finance Agent Benchmark.
Hodnoticí dimenze
AI agenty Microsoft hodnotil podle několika metrik navržených tak, aby ukázaly, jak dobře odpovědi odpovídají očekáváním finančních profesionálů:
- Accuracy - Sleduje, zda je odpověď věcně správná a odpovídá ověřeným finančním datům nebo „ground truth“ ve finančním systému záznamů Dynamics 365 Finance.
- Citation Rate - Ověřuje, zda odpověď správně odkazuje na zdroje a cituje je na podporu svých tvrzení.
- Clarity - Hodnotí, jak snadno se odpověď čte a chápe, včetně stručnosti a srozumitelnosti.
- Depth - Měří, jak do hloubky odpověď téma rozpracuje a zda jde nad rámec povrchních informací.
- Groundedness - Posuzuje, zda je odpověď opřená o uvedené zdroje a vyhýbá se nepodloženým nebo „halucinovaným“ tvrzením.
- Recency - Sleduje, zda jsou časově citlivé informace aktuální a kde je to relevantní, zda jsou ukotvené ke konkrétním datům.
- Relevance - Hodnotí, zda odpověď přímo řeší dotaz uživatele a drží se zadání.
- Structure - Posuzuje, jak dobře odpověď odpovídá běžným očekáváním ve finančních workfowech, včetně logické návaznosti a prioritizace klíčových poznatků.
Výstupy se bodovaly automaticky s využitím LLM v roli hodnotitele (OpenAI GPT 5.2). Hodnocení se opíralo o předem definovaná a „zoperacionalizovaná“ kritéria (rubric assertions) pro každou dimenzi, aby se omezil prostor pro subjektivní výklad, snížilo zkreslení a zlepšila konzistence i objektivita skórování. Skóre jednotlivých dimenzí se zprůměrovalo v rámci každé oblasti úloh a následně se se stejnou vahou zkombinovalo napříč třemi finančními oblastmi do celkového kompozitního skóre. Výsledkem je benchmark, který ukazuje, v čem jednotliví agenti vynikají a kde mají prostor ke zlepšení. Další podrobnosti včetně metodiky, metrik a definic jsou v GitHub repozitáři: https://github.com/microsoft/FinanceBenchmark.
Výsledky
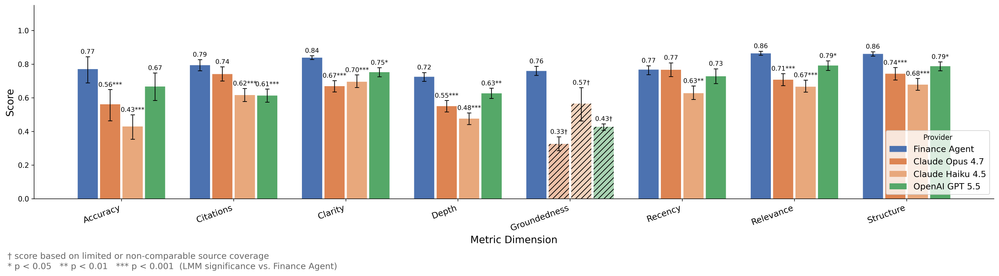
Výsledky vycházejí z testování Finance Agent, které proběhlo 8. května 2026 proti externím systémům včetně OpenAI Responses API (GPT 5.5) a Anthropic Claude Code CLI (Claude Opus 4.7 a Haiku 4.5). Systémy byly nastavené s nástroji, jako je Model Context Protocol server pro finance and operations apps (zpřístupňující Microsoft Dynamics 365 Finance, verze 10.0.48), a vyhodnocené pomocí instrukcí a limitů latence navržených tak, aby co nejlépe odpovídaly reálným workflow uživatelů ve financích. Testování probíhalo v kontrolovaných podmínkách a používalo pouze syntetická nebo řízená data, bez jakýchkoli produkčních zákaznických dat. Výsledky nemusí pokrývat všechny reálné scénáře a mohou se lišit podle faktorů, jako je operační systém, hardware, síťové připojení, datové sady, metodiky vyhodnocení a způsob použití.
Finance Agent vychází napříč hodnoticími metrikami nejlépe, protože jeho instrukce byly cíleně vyladěné tak, aby odpovídaly potřebám finančních profesionálů, jak je tyto metriky zachycují. Silný výkon ve faktické správnosti podporuje přístup ke strukturovaným finančním zdrojům dat, jako je MSN Money, v kombinaci s instrukcemi optimalizovanými pro efektivní využití ERP dat přes MCP server pro Microsoft Dynamics 365 Finance. Kromě přesnosti se konzistentní zlepšení v oblasti hloubky, citací, srozumitelnosti, relevance, struktury a groundedness1 opírá o záměrná návrhová rozhodnutí, jejichž cílem je vytvářet výstupy, které jsou transparentní, snadno ověřitelné a přímo použitelné ve finančních workflow.
Ukázkové dotazy pro tři finanční úlohy
Níže jsou uvedené reprezentativní příklady pro tři oblasti úloh ve Finance Agent Benchmark popsané výše. Některé příklady slouží jen pro ilustraci a jsou fiktivní. Nejde o žádné skutečné vazby ani je nelze vyvozovat.
Příprava finančních business briefů:
Dotaz: „Corporate Profile report of Microsoft“
Kompletní odpověď začíná stručným executive summary – ticker, sektor, sídlo, market cap a klíčové finanční ukazatele – a následně ji rozvede do sekcí, které pokrývají business model a lines of business, vedení, konkurenční pozici, finanční výkonnost (tržby za FY, EBITDA, marže, EPS, YoY trendy), strategické priority a rizikové faktory. Pro přesnost je zásadní, aby finanční údaje – market cap, tržby, počet zaměstnanců, jména a funkce ve vedení – odpovídaly nejnovějším oficiálním filings; nesoulad v identitě CEO nebo v klíčových metrikách snižuje hodnocení. Hloubka se posuzuje podle toho, zda je každá sekce podložená konkrétním, dohledatelným zdrojem, a zda jsou případné mezery otevřeně přiznané, místo aby se „zamaskovaly“ odhady. Struktura se hodnotí podle toho, jestli odpověď začíná tím nejdůležitějším, používá přehlednou hierarchii nadpisů a je uspořádaná tak, aby ji finanční profesionál mohl použít bez dalšího přeformátování.
Průzkum finančních závazků entit vůči uživatelské firmě:
Dotaz: Kteří zákazníci ve Group 90 v USMF mají po splatnosti déle než 90 dní a jakých je top 10 podle výše po splatnosti k 2. březnu 2026?
Správná odpověď identifikuje top 10 zákazníků v USMF ze customer group 90 se zůstatky po splatnosti delší než 90 dní a seřadí je sestupně: The Phone Company (SYNCUS-0025, $182,539.15), Northwind Traders Europe (SYNCUS-0327, $173,961.25), Fourth Coffee Pro (SYNCUS-0629, $171,810.59), A. Datum Retail (SYNCUS-0477, $169,758.98), Northwind Traders (SYNCUS-0019, $167,513.61), City Power & Light Europe (SYNCUS-0985, $166,496.40), Adventure Works Americas (SYNCUS-0282, $166,147.50), Adventure Works Europe (SYNCUS-0310, $166,057.25), Tailspin Toys Global (SYNCUS-0919, $165,614.07) a Coho Vineyard & Winery Wholesale (SYNCUS-0512, $158,547.55). Náročnost tohoto dotazu spočívá v tom, že agent musí současně aplikovat dva nezávislé filtry – customer group 90 a hranici stáří pohledávky 90+ dní – a teprve potom výsledky seřadit; většina volání nástrojů pro AR aging vrací buď všechny zákazníky, nebo všechny aging buckets, takže model, který vynechá kterýkoli z filtrů, skončí s úplně jinou množinou dat. Hlavním signálem přesnosti je úplnost: ve group 90 je mnoho zákazníků, několik z nich má vysoké zůstatky, ale v mladších aging buckets, a proto se nekvalifikují – za chybu se považuje jak zařazení „těsně vedle“, tak vynechání skutečné položky z top 10. Na hraně rozhoduje i aritmetická přesnost – 10. položka ($158,547.55) je blízko několika nekvalifikujících se zákazníků, takže i drobná chyba ve filtrování nebo řazení může způsobit záměnu výsledku. Hloubka oceňuje odpovědi, které jdou nad rámec samotného žebříčku: uvedou celkovou expozici po splatnosti napříč těmito 10 účty, upozorní, že nejvyšší položky jsou téměř o 15 % vyšší než 10. místo, a okomentují, zda je riziko koncentrované do několika účtů, nebo rozložené rovnoměrně. Struktura vyžaduje, aby každá položka obsahovala account ID spolu se jménem a zůstatkem – ideálně v tabulce nebo konzistentním seznamu; ID jsou klíčová pro jednoznačnou identifikaci, protože některá jména zákazníků sdílejí stejné prefixy (Adventure Works Americas vs. Europe).
Výzkum finanční výkonnosti subjektů:
Dotaz: „Porovnejte UnitedHealth Group a CVS Health v Medicare Advantage pro rok 2024: počet členů v pěti největších státech, meziroční růst a jak aktualizace sazeb CMS pro roky 2024 a 2025 ovlivnily jejich výhled a medical loss ratio. Zjištění prezentujte v přehledné srovnávací tabulce.“
Kompletní odpověď musí obsahovat správně naformátovanou srovnávací tabulku, kde budou firmy ve sloupcích a konkrétní metriky v řádcích. Všechny peněžní částky a procenta mají být uvedené na dvě desetinná místa a u údajů o počtu členů musí být jasně uvedené datum, ke kterému platí. Přesnost vyžaduje počty členů na úrovni jednotlivých států (ne jen seřazený seznam států) a skutečné FY2024 medical loss ratio převzaté z GAAP filings nebo earnings releases – nikoli orientační rozpětí ze sekundárních zdrojů. Požadovaná hloubka znamená, že část o sazbách CMS musí být konkrétně navázaná na guidance a MLR každé společnosti; pokud některá data nejsou dostupná, má to být výslovně uvedeno, ne jen nepřímo naznačeno. U struktury se hodnotí, zda je tabulka logicky uspořádaná a snadno čitelná, zda shrnutí informace syntetizuje (místo pouhého zopakování tabulky) a zda je analýza sazeb CMS samostatný text – ne „schovaná“ do buněk tabulky.
1 U externích AI agentů je „groundedness“ ze své podstaty obtížné hodnotit, protože vracejí jen část zdrojů, které při odpovědi použili. Microsoft se sice pokusil tyto zdroje pro offline vyhodnocení zpětně zrekonstruovat, ale nepodařilo se konzistentně zajistit úplné pokrytí.
Tento článek vznikl s využitím materiálu z techcommunity.microsoft.com. Osobní postřehy a komentáře jsou moje vlastní.